
Paper Page Efficient Llm Inference Solution On Intel Gpu

Intel presents Efficient LLM inference solution on Intel GPU paper page ...
Paper page - Efficient LLM inference solution on Intel GPU

Figure 3 from Efficient LLM inference solution on Intel GPU | Semantic ...
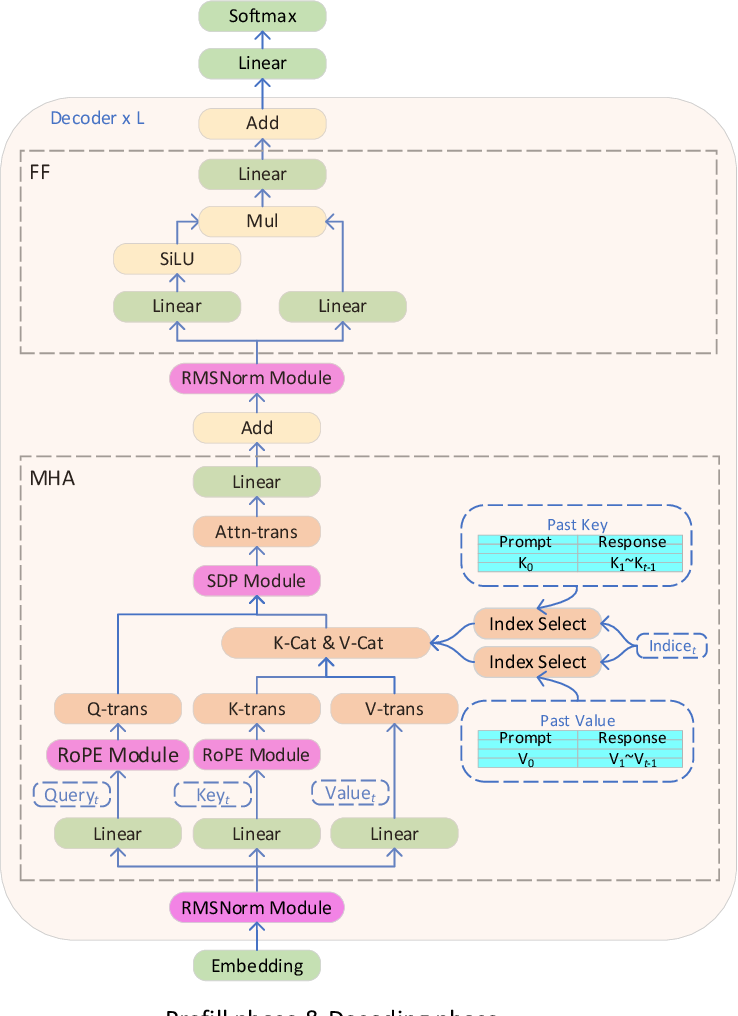
Figure 1 from Efficient LLM inference solution on Intel GPU | Semantic ...

Figure 2 from Efficient LLM inference solution on Intel GPU | Semantic ...

Table 1 from Efficient LLM inference solution on Intel GPU | Semantic ...

Figure 6 from Efficient LLM inference solution on Intel GPU | Semantic ...

Efficient LLM-An efficient solution for LLM inference on Intel GPUs.
Paper page - Efficient LLM Inference on CPUs

Paper page - Parallel CPU-GPU Execution for LLM Inference on ...
Advertisement Space (300x250)

Demo | LLM Inference on Intel® Data Center GPU Flex Series | Intel ...

Paper page - Characterizing and Optimizing LLM Inference Workloads on ...

Paper page - Efficient LLM Inference with Kcache

Paper page - CHAI: Clustered Head Attention for Efficient LLM Inference
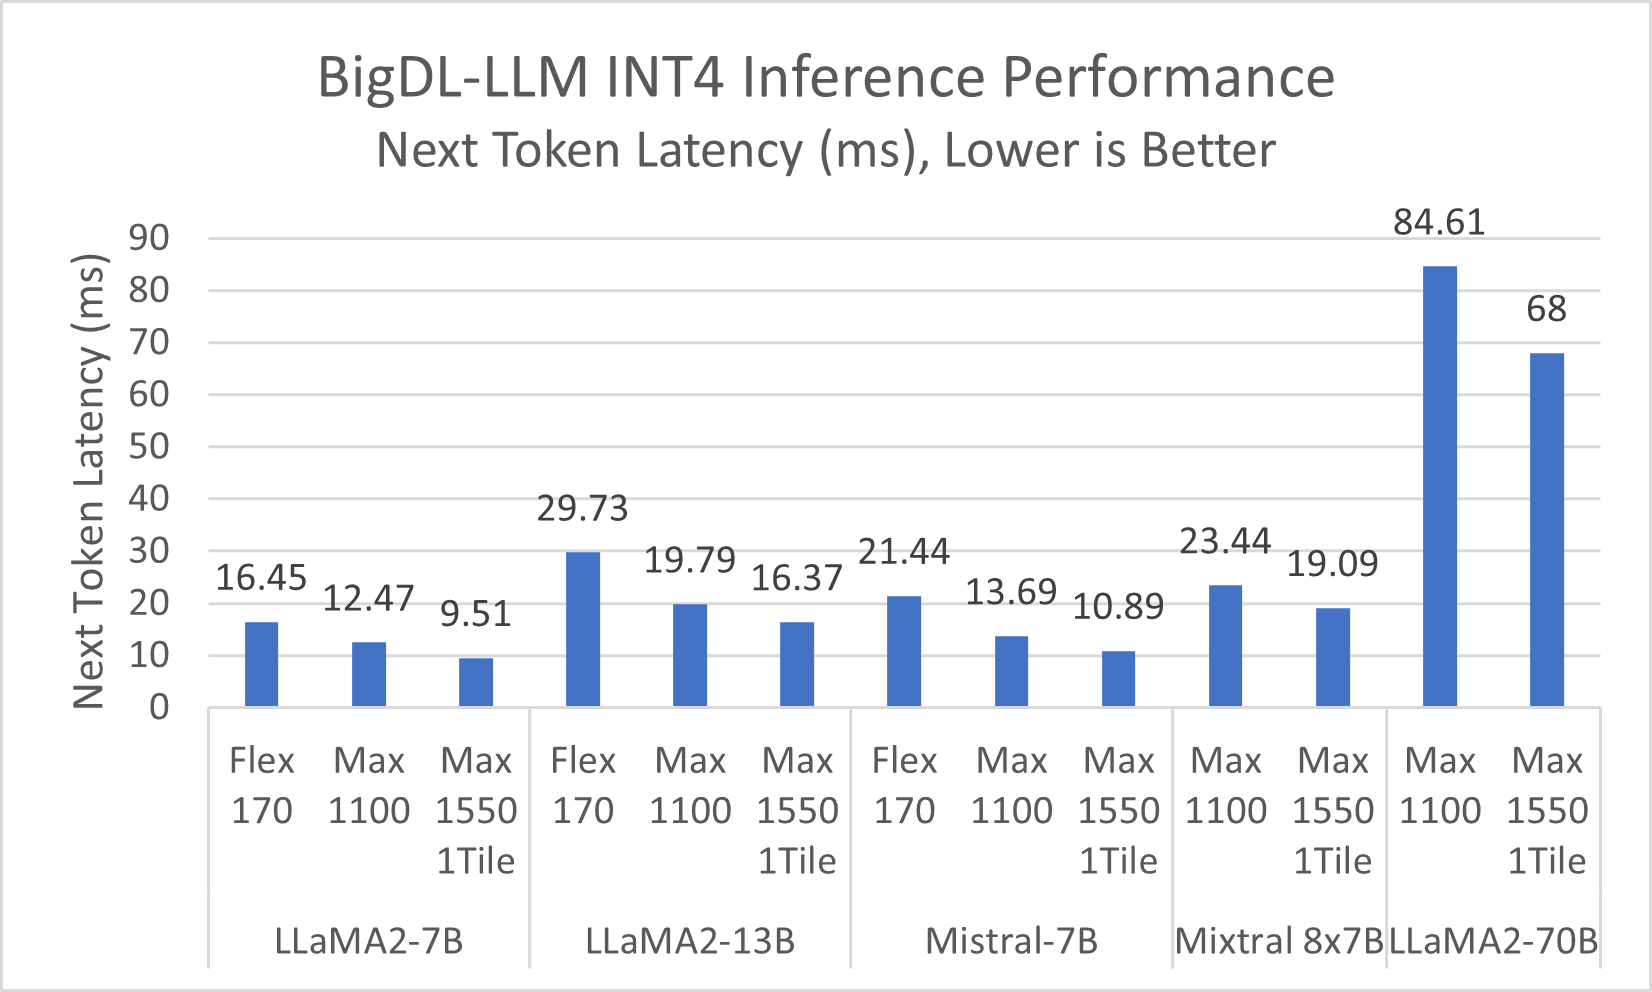
Accelerating LLM Inference on Intel Data Center GPUs using BigDL LLM

SLO-aware GPU Frequency Scaling for Energy Efficient LLM Inference ...
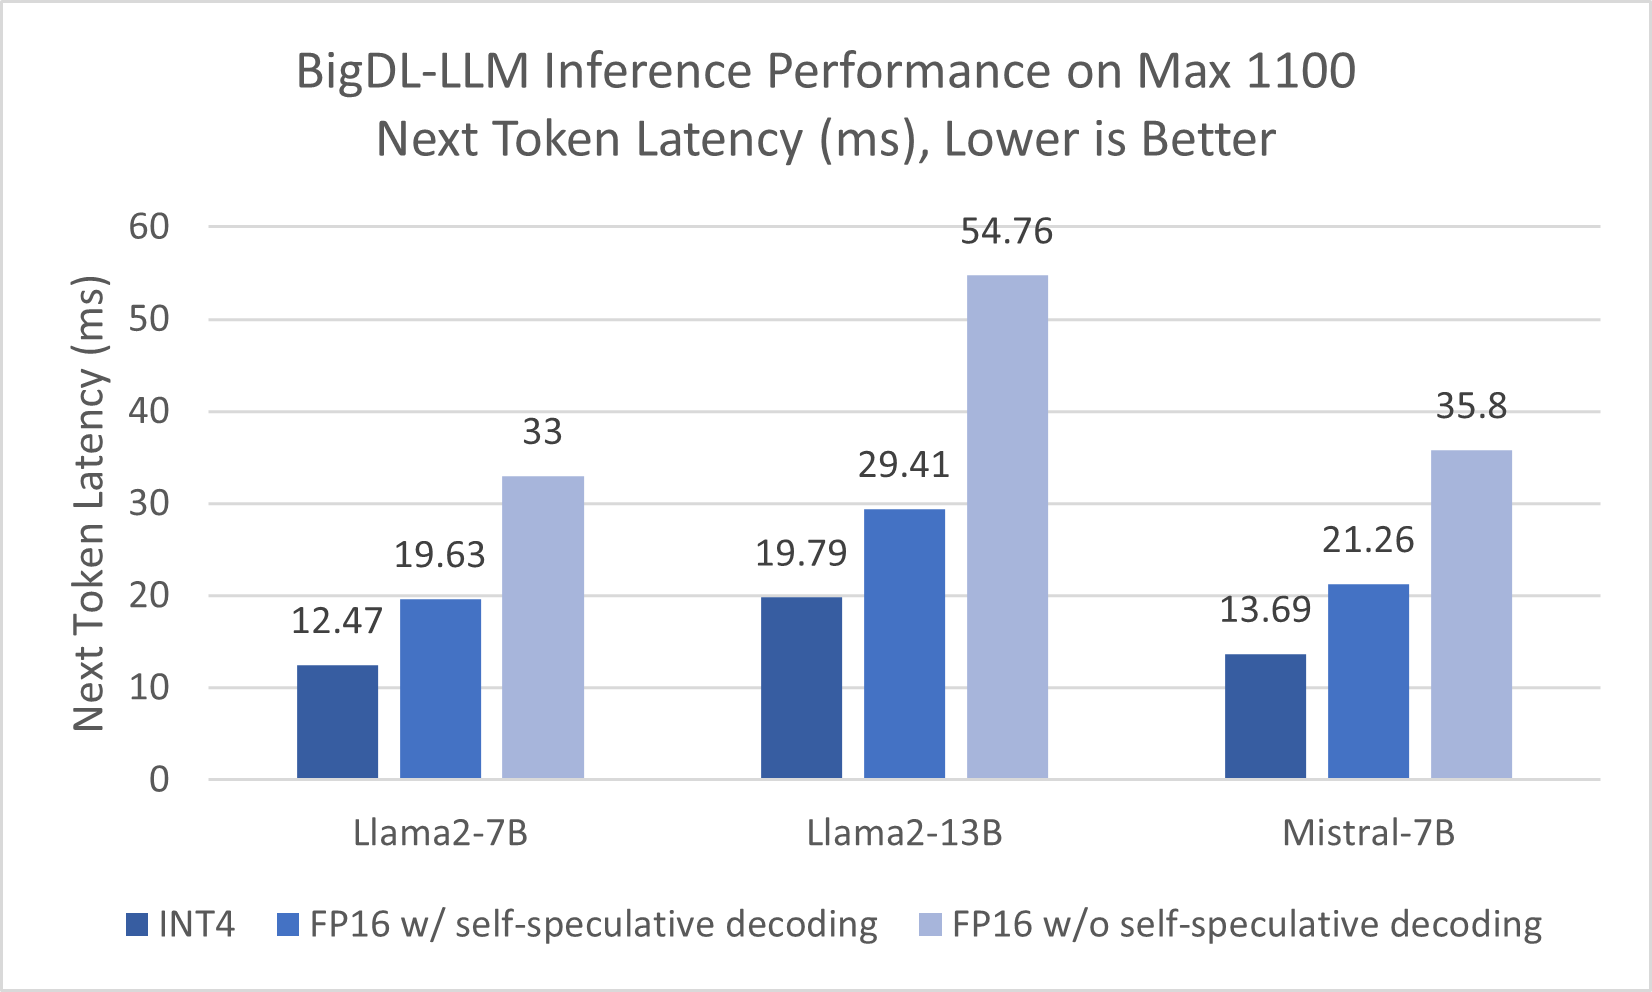
Accelerating LLM Inference on Intel Data Center GPUs using BigDL LLM

[论文评述] SpecOffload: Unlocking Latent GPU Capacity for LLM Inference on ...

Paper page - LUT-LLM: Efficient Large Language Model Inference with ...

SLO-aware GPU Frequency Scaling for Energy Efficient LLM Inference ...
Advertisement Space (336x280)

Paper page - SparQ Attention: Bandwidth-Efficient LLM Inference

Paper page - Scheduling LLM Inference with Uncertainty-Aware Output ...

Paper page - AccLLM: Accelerating Long-Context LLM Inference Via ...

SLO-aware GPU Frequency Scaling for Energy Efficient LLM Inference ...

Paper page - User-LLM: Efficient LLM Contextualization with User Embeddings

Free Video: LLM Efficient Inference in CPUs and Intel GPUs - Intel ...

Paper page - Dynamic Model Routing and Cascading for Efficient LLM ...
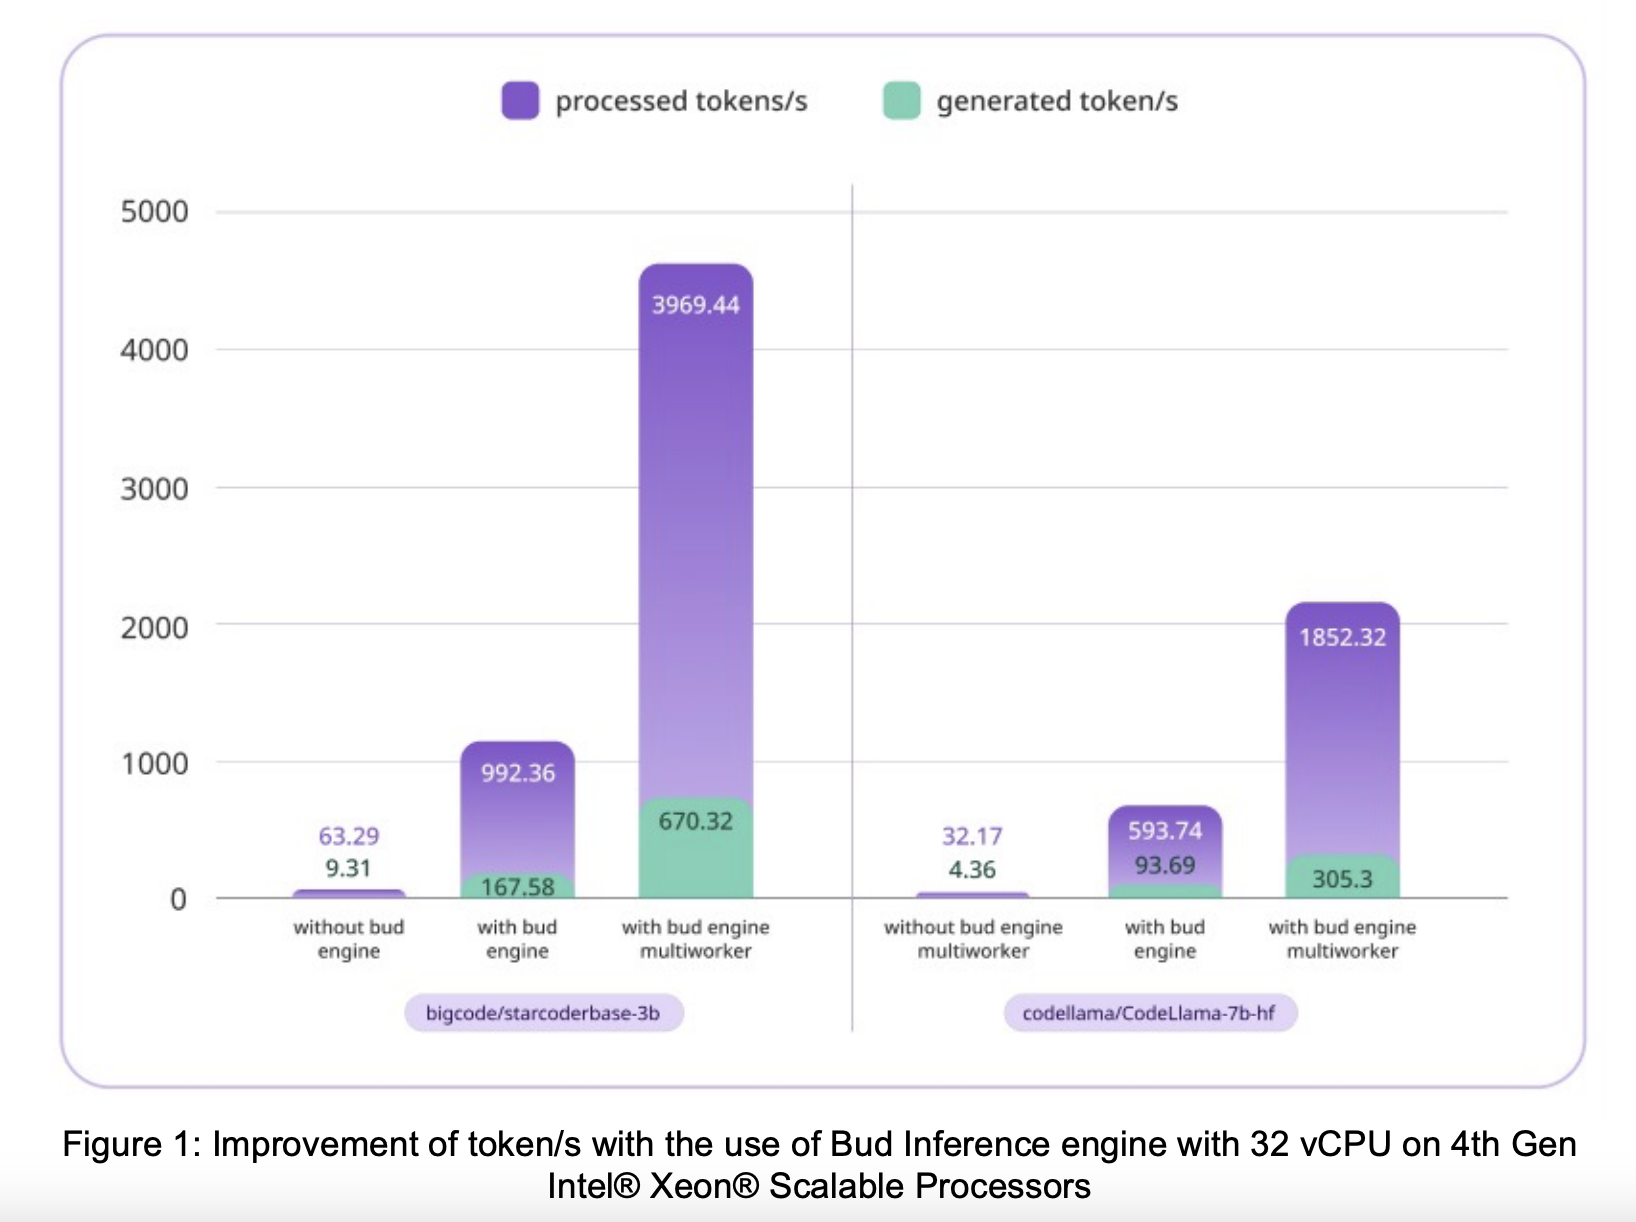
Enhancing LLM inference performance on Intel CPUs - BudEcosystem
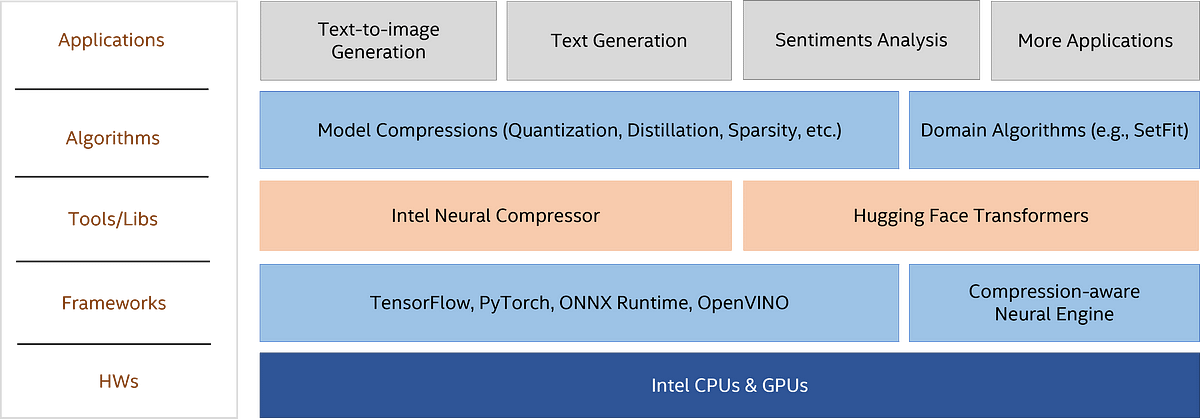
Highly-efficient LLM Inference on Intel Platforms | by Intel(R) Neural ...

Intel AutoRound Enables Faster & More Efficient Quantized LLM Models On ...
Advertisement Space (336x280)

Paper page - Seesaw: High-throughput LLM Inference via Model Re-sharding

[논문 리뷰] SLO-aware GPU Frequency Scaling for Energy Efficient LLM ...

Learn LLM Optimization Using Transformers and PyTorch* on Intel ...

Optimizing LLM Inference on Intel® Gaudi® Accelerators with llm-d ...

Paper page - MixPE: Quantization and Hardware Co-design for Efficient ...
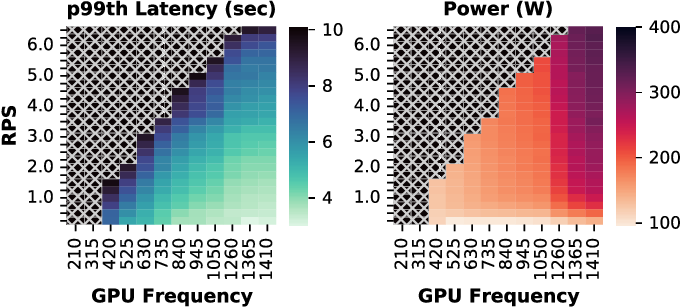
Figure 1 from SLO-Aware GPU DVFS for Energy-Efficient LLM Inference ...